サポート外のRadeon 780MでStable DiffusionをGPU高速化する
うちのNucBox K8 PlusミニPCには、Radeon 780Mを内蔵したRyzen APUが載っています。 AMD内部の呼び方だとgfx1103です。ノートPCやミニPCによく使われている、ありふれた チップです。それなのにAMD自身のROCmビルドはこのチップを見捨てていて、rocBLASと MIOpenのコンパイル済みカーネルにgfx1103用のものが公式バイナリに入っていません。 ComfyUIでStable DiffusionをGPUで動かしたいと思いました。
DirectMLは動くが、すぐ止まる
DirectMLはComfyUIがAMDのGPU向けに用意している標準ルートです。torch-directmlを 入れるだけで、特殊なドライバ設定は要りません。動かしてすぐ、一枚も生成できて いない段階でUnicodeDecodeErrorに当たりました。原因はDirectML内部のネイティブな 文字列デコード処理で、Windowsのロケール、日本語のShift-JISでつまずいていました。 システムロケールを英語UTF-8に切り替えたら直りました。
それ以降、小さいジョブは動きました。512×512でサンプリングステップが8前後を 超えると、ドライバごとクラッシュするか(「GPU will not respond to more commands」)、メモリ不足で落ちるかのどちらかでした。プロンプトとステップ数を 変えて何度も試しましたが、この上限は毎回同じ場所で来ました。ComfyUI自身の起動時 の警告どおりです。torch-directmlはほとんどメンテナンスされていません。手早い プレビューには十分ですが、このクラッシュの壁があると本番の生成には使えません。
本命はZLUDA
ZLUDAはCUDA呼び出しをDLLレベルで横取りして、AMDのROCm/HIPスタックに変換します。 おかげで市販のCUDA版PyTorchを、そのままAMDのハードウェアで動かせます。gfx1103 向けに個人でコンパイルされたrocBLASカーネルがすでにコミュニティにあり、AMDが 残した穴を埋めていました。同世代のAPU(RX 8600G系)で実際の速度向上が出たという 報告も見かけていました。
動かすまでに必要だったのは、AMD HIP SDK、SDKのbinフォルダに入れるパッチ済みの rocBLASとhipBLASLtライブラリ、ZLUDA対応のComfyUIフォーク「ComfyUI-Zluda」、 そしてextra_model_paths.yamlで設定する別のモデルディレクトリでした。
立ちはだかった8つのバグ
この構成が動くまでに、8つの別々の不具合が立ちはだかりました。原因はどれも 別物でした。
-
スクリプトが黙って「認識されない」。
install-n.batや単純なテスト スクリプトさえ実行を拒み、まともなエラーも出ませんでした。原因はWindowsのNoDefaultCurrentDirectoryInExePathという強化設定で、カレントディレクトリ にあるファイル名だけでの実行をブロックしていました。すべての呼び出しに.\を付けたら直りました。 -
**ZLUDAが差し込んだ
nccl.dllが消え続ける。**ZLUDAはNCCL呼び出しを迂回 させるためにこのDLLを差し替えるのですが、Windows Defenderがリアルタイム 脅威として黙って削除していました。ComfyUIのフォルダをDefenderの除外対象 にしたら削除は止まりました。 -
**それでもクラッシュが続く。**Defenderとは別の、Smart App Controlという もう一段厳しい仕組みが、同じ差し込みバイナリを独自にブロックしていました。 通常の隔離ログには一切出てきません。オフにしたらクラッシュは止まりました が、これは片道切符です。後で戻すにはWindowsをクリーンインストールし直す 必要があり、その前に十分に検討する価値があります。
-
環境変数がシェルセッションをまたぐと消える。
HIP_PATHとSDKのPATHエントリを、あるシェルで設定しても次のシェルでは消えていました。実行中の プロセスで設定した環境変数は、新しいシェルには引き継がれないというだけ です。システムレベルで設定し直したら定着しました。 -
**インストーラーに埋め込まれたnumpy/scipyのバージョン不一致。**セット アップスクリプト自身のコメントに「一時的な対処」と書かれたnumpyの固定 バージョンが、実際にインストールされているscipyの要求と噛み合っていません でした。scipyが求めるバージョンにnumpyを上げたら解決しました。
-
**
torch.nn.functional.linearでの深刻なアクセス違反クラッシュ。**fp16 でもfp32でも毎回同じように再現しました。原因はHIP SDK 6.2.4に同梱されて いるrocBLASとTensileのカーネルバイナリ自体でした。別に個別コンパイル されたカーネルを持つHIP SDK 6.4.2に切り替えたら、クラッシュは出なくなり ました。 -
**MIOpenの畳み込みが「unable to find an engine」で失敗する。**gfx1103には MIOpenのプリコンパイル済みカーネルデータベースがそもそも存在しません。 これもAMD自身のツール群に残された穴です。cuDNNとMIOpenをグローバルに 無効化し、PyTorchのネイティブな畳み込みパスに切り替えたら、生成は問題なく 続きました。
-
**VAEDecodeをクラッシュさせる残留カスタムノード。**プロジェクト自身の cuDNN切り替えヘルパーノードが、cuDNNをすでにグローバルで無効化した後では 壊れてしまいました。その時点で不要になっていたので、削除しました。
結果
以前は、CPUだけ(1ステップあたり5秒前後)か、クラッシュするまでの短い時間だけ 動くDirectMLしかありませんでした。8つの修正をすべて入れた後は、ZLUDAはモデル サイズや解像度が変わっても安定して動きます。
| テスト | モデル | 解像度 | 時間 | 速度 |
|---|---|---|---|---|
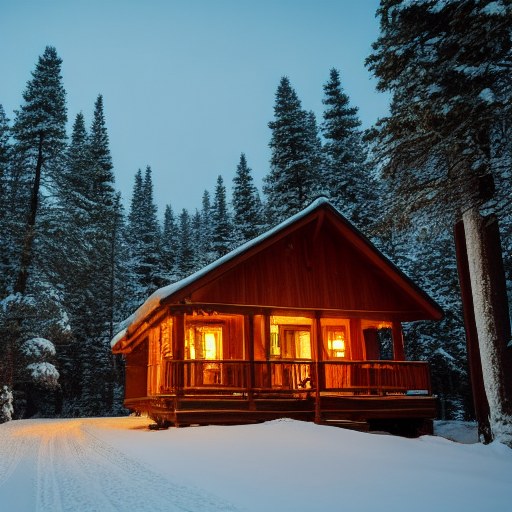
| 山小屋 | SD 1.5 | 512×512 | 20.7秒 | ~1.46 it/s |
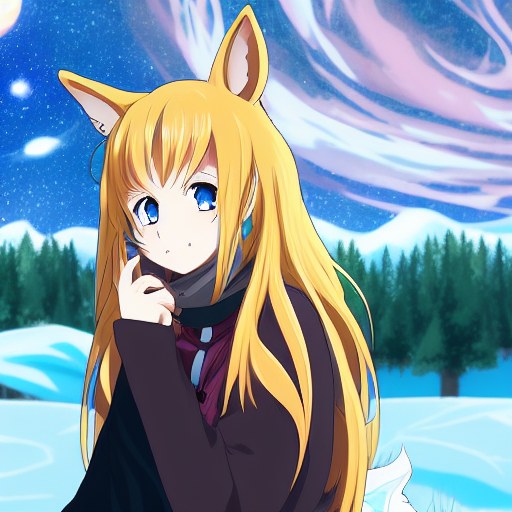
| アニメ調の狐娘 | SD 1.5 | 512×512 | 20.0秒 | ~1.46 it/s |
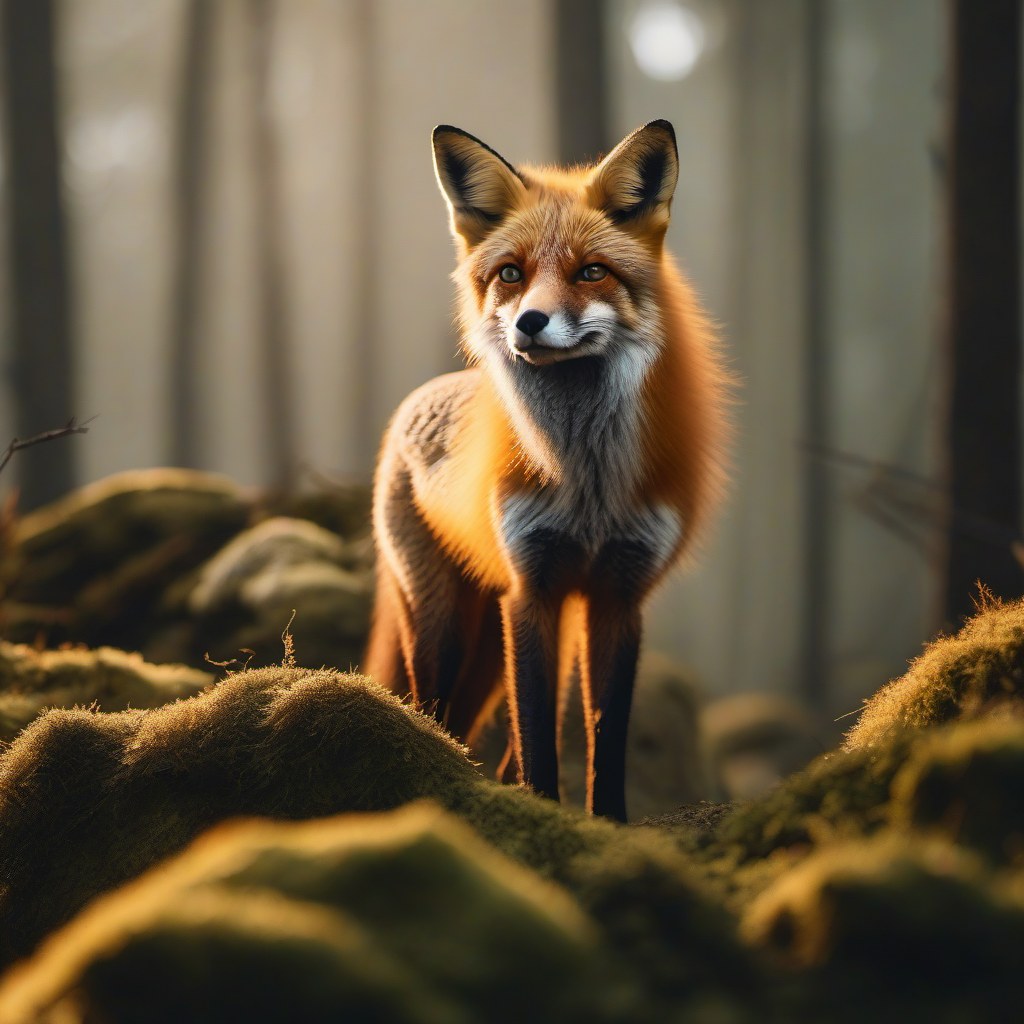
| 狐の写真 | SDXL | 1024×1024 | 98.4秒 | ~4.1s/it |
SDXLの実行はピクセル数が4倍になる分、1ステップあたりのコストが上がっています が、これは想定どおりです。3つとも、イテレーション自体の速度は一貫していました。
このGPUで同じ問題に当たった人へ
エラー文をそのまま検索してここに来た人向けに、直接読む価値のある2つのGitHub issueがあります。rocBLASのTensileLibraryにgfx1103が抜けている件 と、MIOpenのプリコンパイル済み畳み込みデータベースにgfx1103が抜けている件 です。どちらも、これが手元の設定ミスではないことを裏付けています。
Smart App Controlをオフにしないと、ZLUDAが差し込んだバイナリは生き残れません。 元に戻すにはWindowsの再インストールが要るので、始める前に知っておく価値が あります。
この構成のバイナリは、rocBLASのパッチからZLUDAのフォーク、HIP SDKのバージョン の組み合わせまで、すべてAMDの公式サポート外のコミュニティの成果です。個人の パソコンでローカル生成を回す分には問題なく動いています。本番環境の近くには 置きたくありません。
(追記: AMD自身のツール側がこの構成を丸ごと引退させられるくらいには追いついて きました。TheRockへの乗り換えを書いた記事もどうぞ。 同じチップは、のちにまったく違うペースで20B級の画像モデルも動かすことになりました。 Qwen-Image-2512の記事へ。)