RX 6800でコードを書き、Radeon 780Mでスプライトを生成する
Radeon 780Mで動かしていたQwen3.8-27Bは、毎秒約7トークンで生成していた。2万トークンのプロンプトでは、最初のトークンが出るまで6分かかった(以前の実行)。ComfyUI用に設定したRX 6800には16GBの専用VRAMがある。コードを書くモデルをこちらに移すと、生成速度は780Mの約3倍になり、内蔵GPUを別の作業に使えるようになった。
780Mでは小さなモデルにコードを修正させるほか、RXのモデルに渡す関数を選ばせた。修正用のプロンプトは短くなったが、今回の実験ではRXのモデルが自分で選んだほうが速かった。両GPUでゲームのコードとスプライトを同時に生成したときは、RXの生成速度は単独で動かしたときとほぼ同じだった。
RX 6800で27Bを動かす
780Mで使っていたものと同じUnslothのQwen3.8-27B-UD-Q3_K_XLを、UnslothがビルドしたVulkan版のllama.cppで動かした。モデルの全レイヤーをRX 6800に載せ、コンテキストは64Kに設定した。アテンションの状態を保持するKVキャッシュはQ8、Flash Attentionは有効、マイクロバッチは256にした。
ソースコードを使って長いプロンプトを作った。入力が長くなるほど処理に時間がかかり、出力の生成速度は毎秒19.1〜22.5トークンだった。
| プロンプト | 最初のトークンまで | プロンプト処理 | 生成 |
|---|---|---|---|
| 14,012トークン | 90秒 | 155 tok/s | 22.5 tok/s |
| 27,151トークン | 211秒 | 129 tok/s | 21.0 tok/s |
| 48,511トークン | 490秒 | 99 tok/s | 19.1 tok/s |
Qwenに組み込まれたマルチトークン予測(MTP)は、780Mでは生成速度が67%上がった。RX 6800では、試したどの設定でも生成が毎秒約7トークンで頭打ちになった。MTPを切ると、短いコンテキストで毎秒23.5トークンだった。マイクロバッチを384以上にすると、llama-benchでのプロンプト処理が毎秒約190トークンから12トークンまで落ちた。
128KのコンテキストではKVキャッシュがカードの16GBを埋め、プロンプト処理は毎秒約9トークンになった。64Kならサーバーが使うVRAMは13.8GBで、少し余裕が残る。
RX 6800のVRAMをほかのプログラムが使っていると、速度が急に落ちた。待機中のRX用ComfyUIサーバーは、モデルを解放した後も2.58GBを確保したままだった。これを動かしたままだと、生成速度はコンテキスト12Kで毎秒22.2トークン、16Kで7.5トークンだった。コンテキストとともに増えたKVキャッシュが、共有システムメモリへあふれたためだ。レイヤーの8%を780Mに移すと急な低下は避けられたが、トークンごとに2枚のカードの間でデータが行き来するので、生成速度は半分になった。今はLLMを使う間、RX用のComfyUIサーバーを止めている。
RXのVRAMをほかのプログラムが使わない状態では、Hermesエージェントは小さなファイル操作の課題を190秒で終えた。最初の試行は、ほかのプログラムがVRAMを使い、コンテキストも128Kで、609秒かかった。この2回では、VRAMの空きとコンテキストの大きさが両方違う。Hermesは64K以上を前提にしていたが、780Mの環境では24Kしか確保できなかった。
仕様書を直してゲームを生成する
Hermesには、以前のハーネスの仕様書からタワーディフェンスのゲームを作らせた。780Mで27Bが止まったのと同じ課題だ。RX 6800では、最初の30分はツールを呼ばずに推論を続け、その後3つのファイルを書き上げた。実行には6,022秒かかり、ブラウザでの検証は38項目中33項目に合格した。
不合格の5項目のうち2項目は、検証側に原因があった。検証スクリプトは、仕様書に書いていないデバッグ用のフィールドenemyPositionsとselectedTowerTypeを読んでいた。ほかにも、タワーのボタンの並び順、splashというid、スマートフォンとデスクトップでのキャンバスの大きさ、キャンバス上でタップする位置を前提にしていた。これらの前提をすべて仕様書に書き足した。
その後は、小さな制御スクリプトから同じ27Bを呼び出した。計画を作らせてから、ファイルごとに分けてコードを生成する。修正では検索文字列と置換文字列を返させ、適用後にブラウザで検証する。合格する項目が増えた場合だけ変更を残した。
| 仕様書 | 進め方 | 結果 | 時間 |
|---|---|---|---|
| 元の版 | Hermesエージェント | 33/38 | 6,022秒 |
| 元の版 | 制御スクリプト | 33/38 | 2,004秒 |
| 修正版 | 制御スクリプト | 最初の生成で38/38 | 生成に907秒 |
| 修正版 | 制御スクリプト(2回目) | 2回の修正を採用して38/38 | 2,228秒 |
元の仕様書では、修正を6回試しても33/38に留まった。修正版の1回目は907秒で全項目に合格したが、その後780MのMiMo-9Bによるレビューに1,208秒を使い、合計では2,137秒かかった。2回目には27Bによるレビューと4回の修正を含み、修正のうち2回を採用した。表の907秒は最初の生成までで、ほかの行は各回の終了までの時間だ。
レビュー役のモデルは、両方とも12,000トークンの出力上限に達した。780MのMiMo-9Bは約20分間コードについて推論し、結論を出さなかった。27BはJSONのリストに「修正不要」の項目を並べ続けた。具体的な指摘は1つだけで、価格80のsplashタワーが「70より大きいこと」という要件に違反すると誤って判定していた。
検証スクリプト自体にも不具合があった。起動したEdgeのプロセスだけを終了させていたが、ヘッドレスのブラウザは別のプロセスツリーで動いていた。検証のたびに、ソフトウェア描画で動くブラウザがいくつか残り、ゲームのループを動かし続けた。数十回実行するとCPUを使い切り、RXの生成速度は毎秒約3.5トークンまで落ちた。今は、実行ごとに用意した一時プロファイルを使うEdgeのプロセスをすべて終了させている。
780Mでコード修正を補助する
780Mを補助役として試すため、38項目すべてに合格するゲームに、ありがちなバグを10個仕込んだ。ループの範囲が1つずれたもの、ループの条件が逆になったもの、ゴールドを消費するはずがスコアから差し引くものなどだ。HUDのフォントを小さくしたバグは検証で検出できなかったので、今回は残る9個の修正を比べた。RX 6800の27Bは9個すべてを直し、7個は1回目で直した。
780MのLing-3.0-tinyは毎秒39トークンで生成でき、27Bより速い。各ラウンドで両モデルに修正を出させ、先に38項目すべてに合格した案を採用した。Lingは9回のうち1回も勝てなかった。修正案を出すたびに88〜103秒かかり、原因の見立ても外れていた。ダメージを与えない式を、敵の位置が更新されない問題だと説明したこともあった。
RXのサーバーを動かしたまま、780Mの空きメモリに収まるほかのモデルでも3つの課題を試した。MiMo-9Bはどれも直せなかった。Qwen3-8BとOrnith-9Bは、デスクトップのキャンバス配置を直した。3件のうち、CSSを直す課題はこれだけだった。
修正に必要な関数を選ばせるときは、780Mのモデルにscript.jsの概要を読ませた。関数名とコメントだけで約800トークンある。選ばれた関数だけを修正役に渡すと、27Bに渡すプロンプトを約11,900トークンから7,000トークンへ短くできた。
| 構成 | 修正できた数 | 1課題あたりの中央値 |
|---|---|---|
| 27Bにファイル全体を渡す(2回) | 9/9, 9/9 | 126秒, 123秒 |
| 780MのQwen3-8Bがコードを選ぶ(3回) | 9/9, 9/9, 7/9 | 97秒, 100秒, 83秒 |
| 27Bが自分でコードを選ぶ | 9/9 | 78秒 |
| 780Mが次の課題のコードを選んでおく | 9/9 | 93秒 |
780Mのモデルは、最初の試行27回のうち25回でバグのある関数を選んだ。27Bは毎回正しい関数を選び、選択にかかった時間は平均7.6秒だった。780MのQwen3-8Bでは、4回それぞれの平均が5.8〜8.7秒だった。
RXで修正している間に次の課題を準備すると、1課題あたり約32秒分の処理を並行して進められた。このうち約22秒はCPUでのブラウザ検証で、780Mによるコードの選択には約6〜9秒かかった。ただし実行時間には大きなばらつきがあり、27Bが同じバグの修正に60秒かかった実行も、301秒かかった実行もあった。
コード生成中にスプライトを作る
780MではすでにComfyUI-TheRockが動いていて、Qwen-Image 2.1の検証ではスプライトも作った。RX 6800で制御スクリプトにゲームを生成させながら、780MではQwen-Image 2.1とW4A8版のテキストエンコーダーで512×512のスプライトを8枚生成した。
最初の試行では、空きRAMが1.46GBまで減り、メモリ監視が画像生成を止めた。LLMサーバーを--no-mmap付きで起動していたため、モデル全体がRX 6800のVRAMで動いているのに、モデルファイルの約8GBをプロセス専用のシステムメモリに保持していた。780MはシステムRAMをグラフィックス用のメモリとして使うので、この8GBを使えなかった。メモリマップを使うと、リクエスト処理中にサーバーが使うシステムRAMは約0.6GBになり、生成速度は変わらなかった。
2回目の試行では、両方の作業が終わった。ゲームは1回の修正の後、1,107秒で38項目すべてに合格した。スプライト8枚は537秒で、1枚あたり52〜71秒だった。ほかに何も動いていないときとほぼ同じだ。RX 6800の生成速度は毎秒22.2〜23.5トークンで、単独でゲームを生成したときとの差は毎秒0.2トークン以内だった。空きRAMは5.2GBを下回らなかった。
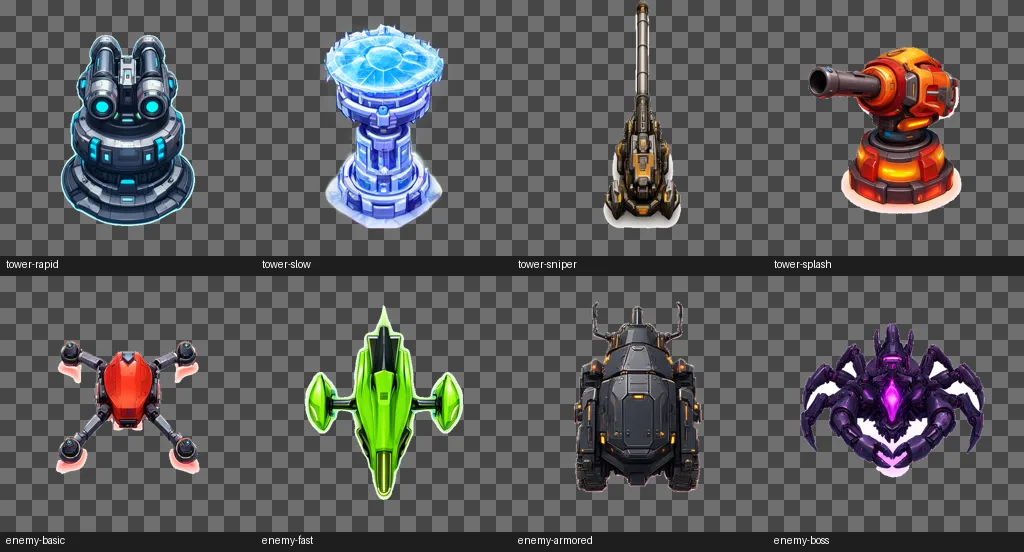
8枚のうち7枚は、背景が不透明な白になっていた。以前、大きい方のテキストエンコーダーで生成したときは背景が透明だった。今は短いスクリプトで、画像の縁につながる白い部分を透明にしている。27Bをもう1回呼び出してスプライトをゲームに組み込み、読み込めないときは元のベクター図形で描くようにした。組み込み後も38項目すべてに合格した。ブラウザで見ると、タワーと敵は生成した絵で描かれている。
実際に遊んでみると、検証で見逃した問題も見つかった。仕様書では、指定したタップ位置の1つでタワーを建てられるよう求めていた。生成したゲームでは敵の通り道がそこを通り、道の上にタワーを置けてしまう。